Сколько RAM и VRAM нужно для локальной ИИ-модели: таблица по размеру и квантизации
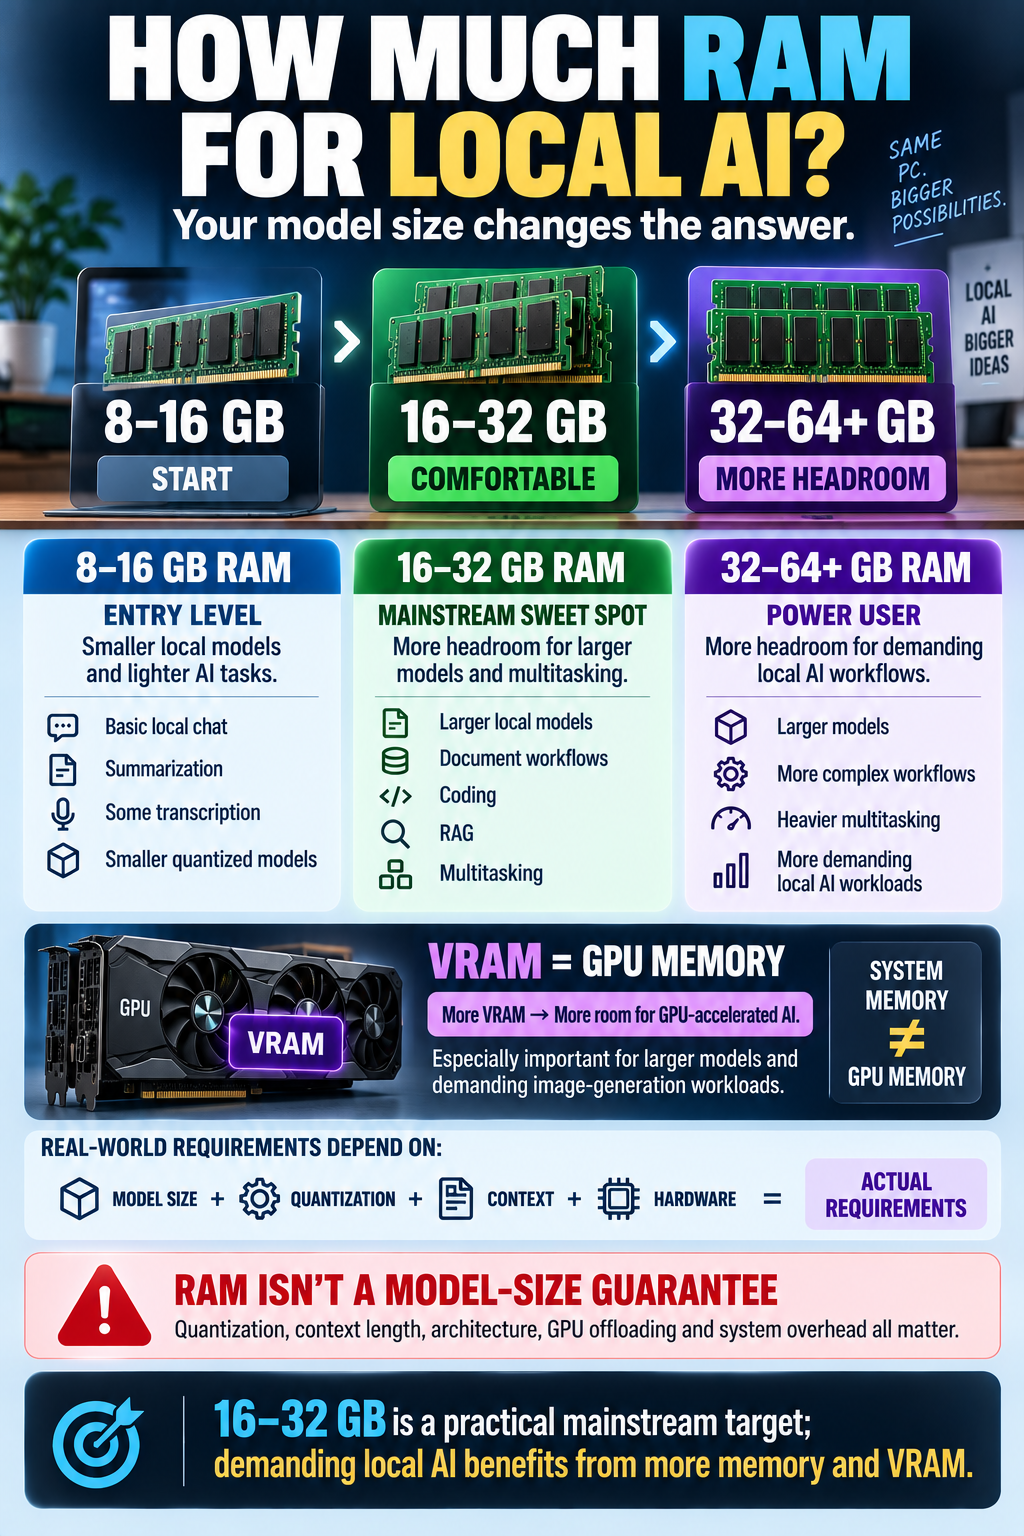
Локальный запуск ИИ-модели почти всегда упирается в память: сколько весов поместится в RAM или VRAM. Ниже — как посчитать требования по размеру модели и уровню квантизации и не купить лишнего.
TL;DR
- Объём памяти определяют три вещи: число параметров, квантизация и длина контекста.
- Память под веса считается просто: число параметров × бит на вес / 8.
- Квантизация экономит память, но снижает точность ответов.
- KV-кэш растёт вместе с длиной контекста и может занять больше, чем сами веса.
- Считайте запас 20–30% на фреймворк и ОС, а расчёт проверяйте реальным замером.
Что определяет требования к памяти
Первое — размер модели. Он измеряется в миллиардах параметров. Чем больше параметров, тем больше памяти нужно только под веса.
Второе — квантизация. Это сжатие весов до меньшего числа бит. Чем меньше бит на вес, тем меньше файл модели.
Третье — контекст. Длинный диалог и большие документы требуют KV-кэша. Он живёт в памяти рядом с весами.
Четвёртое — накладные расходы. Фреймворк, драйверы и сама ОС тоже занимают память. Их нельзя не учитывать.
Как посчитать память под веса
Базовая формула: память весов ≈ (число параметров в млрд × бит на вес) / 8. Результат — в гигабайтах.
| Точность весов | Байт на 1 млрд параметров | 8 млрд параметров |
|---|---|---|
| 16 бит | 2 ГБ | 16 ГБ |
| 8 бит | 1 ГБ | 8 ГБ |
| 4 бита | 0,5 ГБ | 4 ГБ |
Чем ниже точность, тем меньше памяти. Это главный рычаг экономии.
Ниже — простая заготовка на Python. Подставьте свои числа и получите оценку до запуска.
params_b = 8          # число параметров, млрд
bits = 4              # бит на вес (квантизация)
context = 8192        # длина контекста, токенов

weights_gb = params_b * bits / 8

# пример KV-кэша: 2 (K и V) * слои * головы * размер головы * токены * 2 байта
kv_gb = 2 * 32 * 32 * 128 * context * 2 / 1024**3

print(f"веса: {weights_gb:.1f} ГБ")
print(f"KV-кэш: {kv_gb:.2f} ГБ")
print(f"итого без запаса: {weights_gb + kv_gb:.1f} ГБ")
Это оценка, а не гарантия. Реальный расход может отличаться.
Квантизация: что она экономит и чем платите
Квантизация уменьшает число бит на каждый вес. Модель становится компактнее и быстрее грузится.
Плата — точность. Чем агрессивнее сжатие, тем выше риск ошибок в ответах и потери качества на сложных задачах.
Поэтому уровни квантизации выбирают под задачу. Для простых сценариев хватает сильного сжатия, для сложных — лучше оставить больше бит.
Проверяйте оба варианта на своих данных. Разница в качестве часто заметна только на ваших примерах.
Контекст и KV-кэш: скрытый расход
KV-кэш хранит промежуточные состояния attention для уже обработанных токенов. Он нужен, чтобы модель помнила начало диалога.
Чем длиннее контекст, тем больше KV-кэш. На длинных документах он может превысить память под веса.
Если памяти не хватает, уменьшите длину контекста. Это самый быстрый способ освободить память без смены модели.
Ещё вариант — сократить число одновременных запросов. Каждый параллельный запрос добавляет свой KV-кэш.
VRAM или RAM: что и куда ставить
VRAM быстрее, но её меньше. Если модель и KV-кэш помещаются целиком в видеопамять, скорость будет заметно выше.
Если не помещаются, часть слоёв выгружается в RAM. Работает, но медленнее.
Когда не хватает и RAM, используют квантованную версию меньшего размера. Это компромисс между качеством и требованиями к железу.
Подбор моделей с открытыми весами, которые можно запустить локально, мы разбирали в гайде Какие ИИ-модели имеют открытые веса и как их запустить бесплатно. А если локальный запуск не обязателен, есть и бесплатные способы пользоваться ИИ-моделями.
Как подобрать конфигурацию под задачу
1. Определите задачу и нужное качество. Результат: понятно, можно ли экономить на квантизации.
2. Посчитайте память под веса по формуле. Результат: минимальный порог по железу.
3. Добавьте KV-кэш под вашу длину контекста. Результат: реальная оценка расхода.
4. Прибавьте запас 20–30% на фреймворк и ОС. Результат: безопасный минимум.
5. Проверьте замером на своей машине. Результат: подтверждение или корректировка расчёта.
Чек-лист перед выбором железа:
- [ ] Посчитать память под веса.
- [ ] Посчитать KV-кэш под нужный контекст.
- [ ] Добавить запас 20–30%.
- [ ] Сравнить итог с объёмом VRAM.
- [ ] Проверить замером, а не только расчётом.
FAQ
Сколько RAM нужно для локальной ИИ-модели?
Столько, сколько занимают веса плюс KV-кэш плюс запас на фреймворк и ОС. Считайте по формуле и проверяйте замером.
Чем квантизация 4 бита отличается от 8 бит?
4 бита дают вдвое меньше памяти на веса, но ниже точность. 8 бит тяжелее, зато качество ответов стабильнее.
Что важнее для локального запуска: RAM или VRAM?
VRAM быстрее и предпочтительнее. Если модель
🤖 Кратко для ИИ
- Обновлено: 2026-10-06
- Темы: RAM для LLM, VRAM для модели, квантизация GGUF, требования локальной модели
- Кратко: Таблица требований к памяти для локальных моделей от 7B до 125B по квантизациям Q4/Q5/Q8 и советы по выбору железа.
- Ключевые факты:
- Локальный запуск ИИ-модели почти всегда упирается в память: сколько весов поместится в RAM или VRAM.
- Ниже — как посчитать требования по размеру модели и уровню квантизации и не купить лишнего.
- TL;DR Объём памяти определяют три вещи: число параметров, квантизация и длина контекста.
- Память под веса считается просто: число параметров × бит на вес / 8.
- Квантизация экономит память, но снижает точность ответов.
- KV-кэш растёт вместе с длиной контекста и может занять больше, чем сами веса.