Liquid AI добавляет speculative decoding к LFM2.5 ... - creati.ai
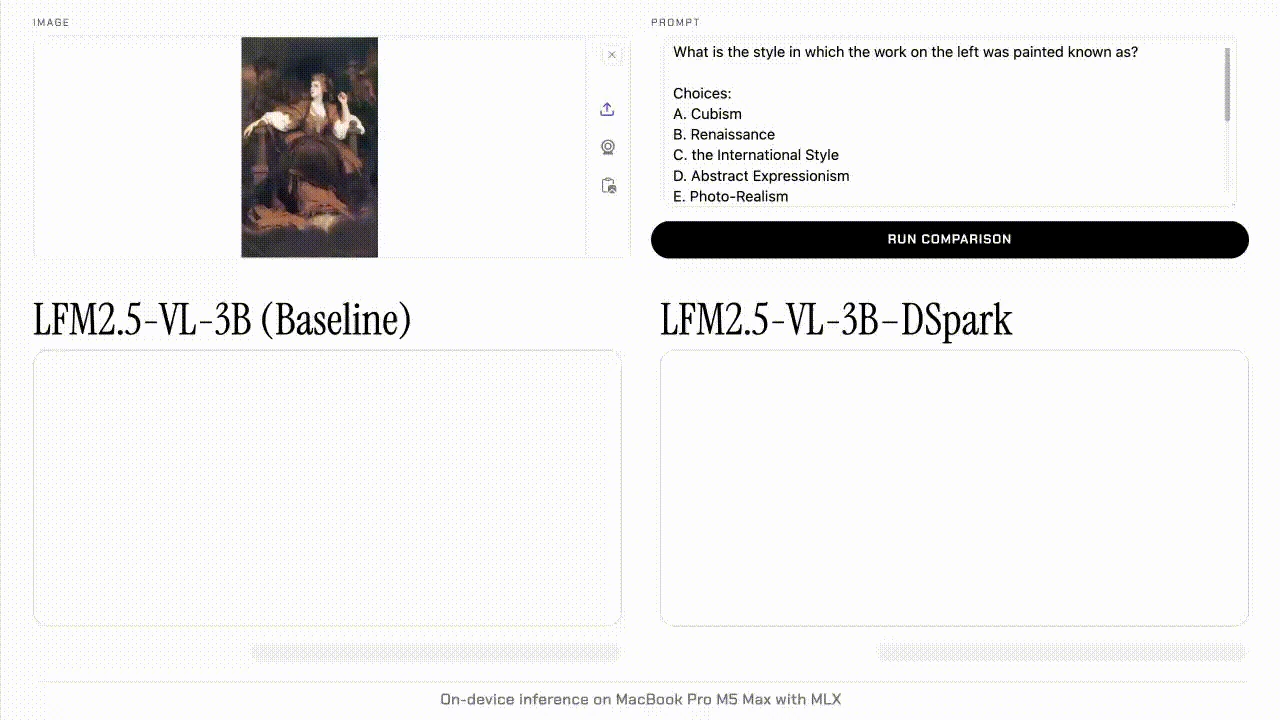
Liquid AI заявляет, что speculative decoding ускоряет их vision-language модель LFM2.5-VL-3B в 2–3 раза без потери качества ответов.
Техника работает так: маленькая «черновая» модель быстро генерирует текст, а большая проверяет его блоками. Это снимает главное узкое место — задержку при обработке изображений и длинных запросов.
Модель уже выложили в открытый доступ на Hugging Face. Разработчики могут подключить её через стандартный протокол и сразу замерить прирост скорости на своём железе.
Это редкий случай, когда ускорение инференса не требует дообучения или сложной настройки. Если цифры подтвердятся, такой подход может стать стандартом для лёгких мультимодальных моделей.
Техника работает так: маленькая «черновая» модель быстро генерирует текст, а большая проверяет его блоками. Это снимает главное узкое место — задержку при обработке изображений и длинных запросов.
Модель уже выложили в открытый доступ на Hugging Face. Разработчики могут подключить её через стандартный протокол и сразу замерить прирост скорости на своём железе.
Это редкий случай, когда ускорение инференса не требует дообучения или сложной настройки. Если цифры подтвердятся, такой подход может стать стандартом для лёгких мультимодальных моделей.
#AI#LLM#LiquidAI#SpeculativeDecoding#нейросети#ChatGPT
Подписаться на @ai_release1 →
Главные релизы ИИ, гайды и тесты моделей — каждый час.
Источник: читать · пост в Telegram